Un RAG souverain, c’est la réponse à la question qu’on nous pose le plus souvent depuis un an : « est-ce que l’IA peut répondre à partir de nos documents, sans qu’ils partent aux Etats-Unis ? » La technique s’appelle le RAG, et elle n’a rien de magique : plutôt que d’entraîner un modèle sur vos données, on lui fait lire les bons passages au moment où la question est posée. L’intérêt, dans une année où la localisation des données devient un sujet juridique, c’est que toute cette chaîne peut désormais tourner en Europe. Nous l’avons montée, voici comment ça marche et ce que ça vaut.
Le RAG, expliqué sans jargon
RAG signifie génération augmentée par la recherche. Le principe est simple : quand vous posez une question, le système va d’abord chercher dans vos documents les passages qui traitent du sujet, puis il les donne à lire au modèle de langage, qui rédige la réponse à partir de ces passages.
Deux conséquences importantes. D’abord, le modèle n’apprend rien de vos documents : il les lit sur le moment, comme un collaborateur consulterait un classeur. Ensuite, la réponse peut être sourcée : le système sait de quel document vient chaque élément, ce qui permet de vérifier. C’est ce qui rend le RAG utilisable en contexte professionnel, là où un modèle qui répond de mémoire ne l’est pas.
Ce point mérite d’être martelé : le RAG ne remplace pas votre jugement, il vous amène au bon paragraphe plus vite. Une réponse sans source vérifiable ne vaut pas grand-chose.
Comment la chaîne fonctionne
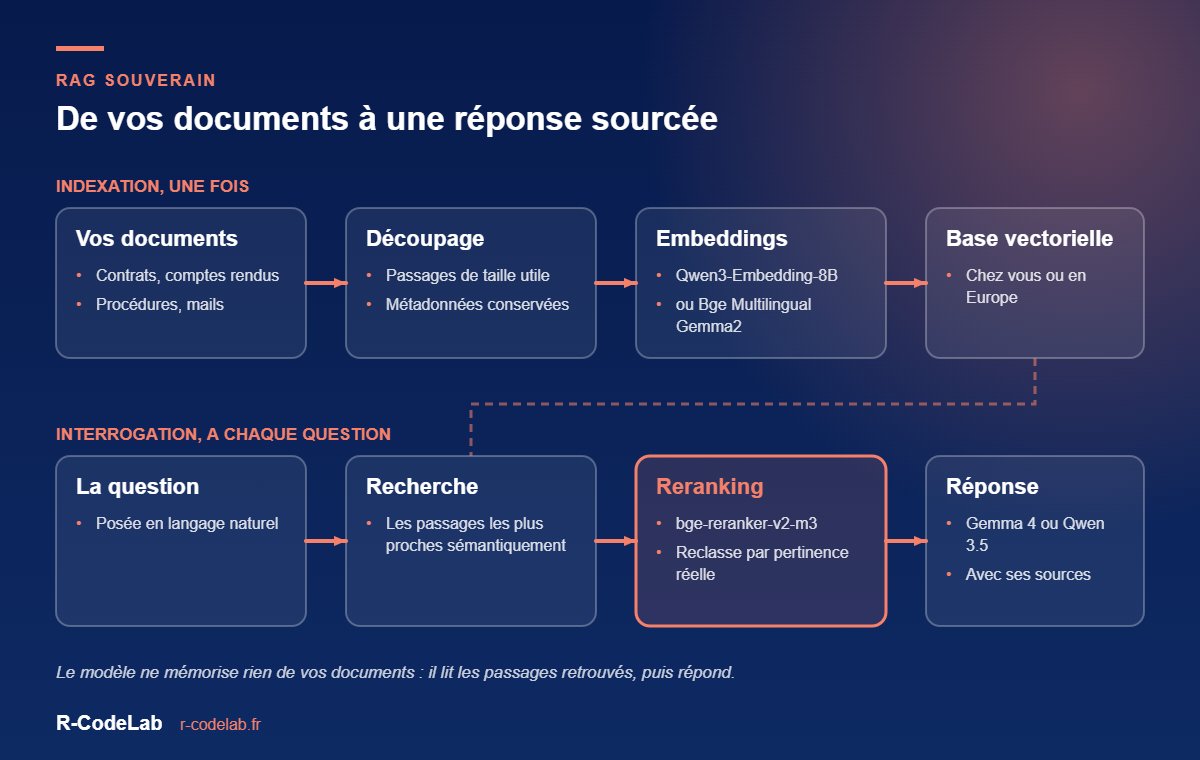
L’indexation se fait une fois, puis à chaque ajout de document. On découpe les documents en passages de taille utile, on conserve leurs métadonnées, puis un modèle d’embedding transforme chaque passage en vecteur, une suite de nombres qui représente son sens. Ces vecteurs vont dans une base vectorielle.
L’interrogation a lieu à chaque question. La question est transformée en vecteur de la même façon, on récupère les passages les plus proches sémantiquement, puis un modèle de reranking les reclasse par pertinence réelle. Enfin, le modèle de langage rédige la réponse à partir des meilleurs passages.
L’étape que tout le monde saute : le reranking
C’est la différence la plus nette entre un RAG de démonstration et un RAG utilisable. La recherche vectorielle est rapide mais approximative : elle ramène des passages qui ressemblent à la question, pas forcément ceux qui y répondent. Sur un fonds documentaire réel, où trente documents parlent du même sujet avec des nuances, cette approximation produit des réponses à côté.
Le reranker compare finement chaque passage candidat à la question et les reclasse. On récupère large, puis on garde le meilleur. C’est une étape peu coûteuse qui améliore nettement la qualité perçue.
Bonne nouvelle : Infomaniak propose deux rerankers dans son catalogue. BAAI/bge-reranker-v2-m3 traite jusqu’à 8 192 tokens et combine analyse lexicale et sémantique, ce qui en fait le choix polyvalent. Qwen/Qwen3-Reranker-0.6B est ultra-léger, avec une fenêtre étendue à 32 768 tokens, pensé pour la faible latence.
Un RAG souverain de bout en bout, c’est désormais possible
C’est ce qui a changé récemment, et c’est le coeur du sujet. Un RAG a besoin de trois briques de modèle, et les trois existent aujourd’hui chez un hébergeur européen :
- Embeddings : Qwen3-Embedding-8B, multilingue, 4 096 dimensions configurables, ou Bge Multilingual Gemma2, présenté comme la référence pour la recherche augmentée. Pour du prototypage ou de très gros volumes simples, All MiniLM L12 v2 suffit et coûte une fraction du prix.
- Reranking : bge-reranker-v2-m3 ou Qwen3-Reranker-0.6B.
- Génération : Gemma 4 pour l’équilibre, Qwen3.5 pour les dossiers volumineux, Apertus pour les secteurs les plus réglementés.
Le tout dans des data centers suisses, avec un engagement explicite : les requêtes ne sont ni enregistrées, ni utilisées pour entraîner les modèles. Précisons ce que cela protège et ce que cela ne protège pas. Vos documents restent dans votre base vectorielle, que vous hébergez où vous voulez. Ce qui transite vers le modèle, ce sont les passages retrouvés au moment de répondre. Le choix d’un modèle open weight ne sécurise rien en soi : il vous donne la possibilité de décider où ce traitement a lieu, ce qu’une API fermée ne permet pas.
Des cas d’usage qui valent le coup
- Le fonds documentaire d’une association. Statuts, comptes rendus d’assemblées, conventions, règlements. Un bénévole nouvellement élu peut demander « qui décide de l’admission d’un membre » et obtenir la réponse avec l’article concerné, au lieu de mobiliser l’ancien président.
- Les procédures internes d’une PME. Un nouveau salarié interroge les modes opératoires sans interrompre un collègue. C’est le cas d’usage où le retour sur investissement est le plus visible.
- Les marchés publics. Retrouver dans un CCTP de deux cents pages les exigences réellement engageantes, et les recouper avec les réponses déjà rédigées sur des consultations passées.
- Le support technique. Interroger la documentation produit, les tickets résolus et les notes de version d’un seul coup, avec la source à l’appui.
- Les dossiers d’exploitation agricole. Cahiers d’épandage, contrats, comptes rendus de contrôle : des documents que l’on consulte rarement mais qu’il faut retrouver vite le jour où on les cherche.
Le dénominateur commun : beaucoup de documents, peu de personnes qui en connaissent le contenu, et des questions récurrentes. Si votre documentation tient en dix pages, un RAG n’apporte rien.
Ce qui fait échouer un projet RAG
Rarement le modèle. Dans un projet de RAG souverain, ce sont presque toujours les documents. Un fonds documentaire mal tenu, avec trois versions d’une même procédure et aucune date, produira des réponses contradictoires, et vous aurez tendance à accuser l’IA. Le RAG révèle la qualité de votre documentation plus qu’il ne la corrige.
Les autres pièges classiques : un découpage des documents trop grossier ou trop fin, l’absence de reranking, l’oubli des droits d’accès quand tout le monde n’a pas à voir tous les documents, et l’absence d’affichage des sources, qui empêche l’utilisateur de vérifier et détruit la confiance à la première erreur.
Si l’objectif est plutôt d’agir que de chercher, c’est vers les agents qu’il faut se tourner : voyez notre comparatif OpenClaw 2 et Hermes Agent. Et pour le choix du modèle, notre article sur les modèles open weight hébergés chez Infomaniak entre dans le détail. Sur la question de l’hébergement des données en général, notre article sur la souveraineté numérique pose le cadre.
Se faire accompagner
R-CodeLab, basé en Vendée, met en place des moteurs de recherche documentaire par IA sur vos propres documents, avec des modèles hébergés en Europe. Audit gratuit et sans engagement de votre fonds documentaire.
Questions fréquentes
RAG ou fine-tuning, quelle différence ?
Le fine-tuning modifie le modèle pour lui donner un style ou un savoir-faire. Le RAG lui donne accès à des documents au moment de répondre. Pour de la connaissance métier qui évolue, le RAG est presque toujours le bon choix : vous ajoutez un document et c’est pris en compte immédiatement, sans réentraîner quoi que ce soit.
Combien de documents faut-il pour que ce soit utile ?
Il n’y a pas de seuil absolu, mais l’intérêt apparaît quand le volume dépasse ce qu’une personne peut garder en tête, soit quelques centaines de pages. En dessous, une bonne recherche en texte intégral fait le travail pour bien moins cher.
Le RAG peut-il inventer des réponses ?
Il réduit fortement le risque sans l’annuler. Si aucun passage pertinent n’est retrouvé, un modèle mal encadré comblera le vide. C’est pourquoi il faut lui demander explicitement de répondre qu’il ne sait pas, et toujours afficher les sources pour que l’utilisateur puisse vérifier.
Sources
- Catalogue des modèles open source, Infomaniak : modèles d’embedding, de reranking et de génération.
- AI Services, Infomaniak : hébergement suisse, conformité LPD et RGPD, non-conservation des requêtes.