Installer un agent IA open source prend une heure. La vraie question arrive juste après : quel modèle brancher derrière. Si vous y mettez une clé OpenAI ou Anthropic, votre agent auto-hébergé envoie quand même tout votre contexte de travail chez un éditeur américain. Les modèles open weight hébergés en Europe changent cette équation, et Infomaniak propose aujourd’hui un catalogue qui permet de le faire sérieusement. Voici comment nous le mettons en place.
Ce que « open weight » veut dire, et ce que ça ne veut pas dire
Un modèle open weight est un modèle dont les poids, c’est-à-dire les paramètres issus de l’entraînement, sont publiés et téléchargeables. Ce n’est pas exactement de l’open source au sens logiciel : les données d’entraînement ne sont pas toujours ouvertes, et les licences varient.
Sur la protection des données, un raccourci est fréquent. Un modèle open weight ne protège rien en lui-même. Ce qu’il vous donne, c’est le choix du lieu d’exécution. Comme les poids sont disponibles, n’importe quel hébergeur peut les faire tourner, et vous n’êtes plus captif de l’infrastructure de l’éditeur. Vous pouvez donc exiger que le modèle tourne en Europe, sous un droit que vous connaissez, chez un prestataire qui s’engage contractuellement sur le traitement de vos requêtes. Avec un modèle fermé, cette exigence est simplement impossible à formuler.
La protection vient donc de la combinaison : poids ouverts, plus un hébergement dont vous vérifiez les engagements.
Ce qu’Infomaniak héberge réellement
Infomaniak opère ses services d’IA depuis ses data centers en Suisse, avec une API compatible OpenAI. Deux engagements comptent ici : les requêtes ne sont ni enregistrées, ni utilisées pour entraîner les modèles ou améliorer leurs services, et l’infrastructure est soumise à la LPD suisse et au RGPD.
Côté catalogue, deux modèles se détachent pour un usage agent :
- Gemma 4 31B (
google/gemma-4-31B-it) est présenté comme l’équilibre du catalogue. Plus de 140 langues, et surtout un appel de fonctions qualifié de natif et optimisé. Pour un agent, cette capacité à appeler proprement des outils compte davantage que le score brut sur un classement - Qwen se décline en deux modèles, tous deux en bêta.
Qwen/Qwen3.5-397B-A17B-FP8est le plus puissant du catalogue, orienté raisonnement complexe, planification multi-étapes et exécution d’outils, avec 200 000 tokens de contexte.Qwen/Qwen3.8-27B-FP8, plus compact, offre 100 000 tokens de contexte et lit nativement les images et les documents. Les deux couvrent plus de 100 langues
Le catalogue comprend aussi Mistral Small 4 et ses 256 000 tokens de contexte, Ministral 3, Apertus de swiss-ai pour les contextes les plus réglementés et Kimi K2.6 orienté code. Tous annoncent l’appel de fonctions. S’y ajoutent des modèles d’embeddings (Qwen3-Embedding-8B, BGE Multilingual Gemma2) et de reclassement (bge-reranker-v2-m3, Qwen3-Reranker-0.6B), les briques d’une recherche dans vos propres documents.
Ce catalogue évolue d’un mois sur l’autre : la liste ci-dessus est à jour au 13 novembre 2026. Vérifiez l’identifiant exact sur la page des modèles d’Infomaniak avant de configurer votre agent.
Comment les données circulent réellement
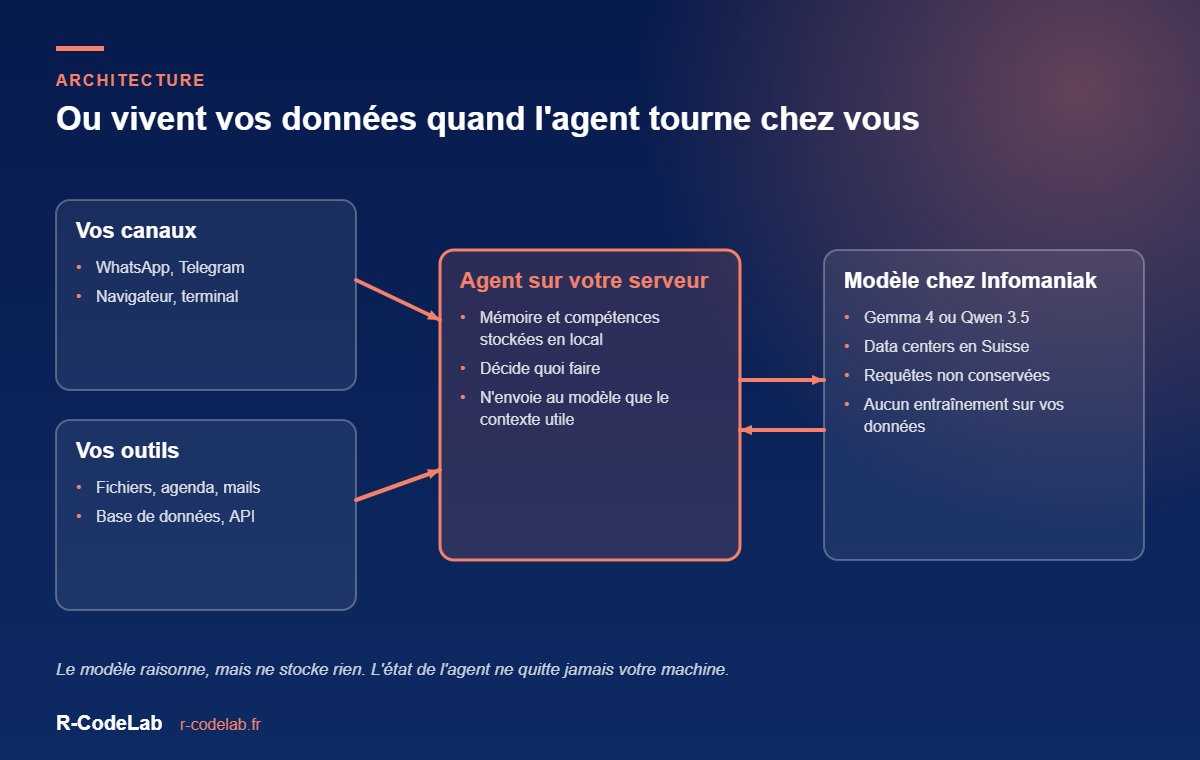
Ce point est souvent simplifié. Votre agent conserve chez vous sa mémoire, ses compétences, ses identifiants et son historique. Ce qui part vers le modèle, ce sont les fragments de contexte nécessaires à chaque requête. Beaucoup moins que « toutes vos données », mais ce n’est pas rien non plus : si l’agent résume un contrat, le contrat passe.
D’où l’intérêt de savoir précisément où ce traitement a lieu et ce que le prestataire en fait. C’est exactement ce que permet un modèle open weight hébergé en Suisse plutôt qu’une API fermée.
Le raccordement en pratique
Infomaniak ne figure pas dans le répertoire des fournisseurs pris en charge nativement par OpenClaw. Ce n’est pas bloquant, parce que son API est compatible OpenAI et qu’OpenClaw prévoit explicitement ce cas. Sa documentation indique que l’on peut déclarer un fournisseur personnalisé, via la configuration des fournisseurs de modèles, pour pointer vers une URL de base compatible OpenAI ou Anthropic.
La marche à suivre tient en quatre étapes :
- Créer une clé API dans votre espace Infomaniak. La plateforme offre un million de crédits pour tester, puis facture à l’usage
- Déclarer un fournisseur personnalisé dans la configuration de l’agent, avec l’URL de base de l’API et la clé
- Renseigner l’identifiant exact du modèle, par exemple
google/gemma-4-31B-it, et le déclarer comme modèle principal - Vérifier l’appel d’outils sur une tâche simple avant de confier quoi que ce soit de sérieux. C’est là que se révèlent les écarts entre modèles
Déclarez explicitement les capacités du modèle dans la configuration, notamment s’il accepte les images. Les harnais d’agents s’appuient sur ces métadonnées pour décider quoi envoyer, et un modèle mal déclaré produit des erreurs difficiles à diagnostiquer.
Quel modèle pour quel usage
- Agent du quotidien, tri de mails, classement, relances : Gemma 4. L’appel de fonctions natif et la latence contenue en font le choix par défaut. Inutile de payer un modèle de raisonnement pour ranger des fichiers
- Tâches multi-étapes, analyse de dossiers longs : Mistral Small 4, pour ses 256 000 tokens de contexte et sa bascule entre instruction simple et raisonnement
- Raisonnement complexe ou planification difficile : Qwen3.5 397B, à réserver aux cas qui le justifient
- Développement, génération de code : Kimi K2.6, encore en bêta, présenté par Infomaniak comme son modèle le plus puissant pour le code. Il transforme aussi des maquettes ou des captures d’écran en code, avec 256 000 tokens de contexte pour travailler sur un projet entier
- Secteur réglementé, administration : Apertus, positionné sur la transparence des poids et des données d’entraînement
Le bon réflexe est d’utiliser le plus petit modèle qui fait le travail. C’est moins cher, plus rapide, et plus sobre. Nous revenons sur ce choix dans notre article sur l’IA locale et open weight.
Sur le choix de l’agent lui-même, voyez notre comparatif OpenClaw 2 et Hermes Agent. Et si votre besoin est d’interroger un fonds documentaire plutôt que d’agir, c’est vers le RAG souverain qu’il faut regarder.
Se faire accompagner
R-CodeLab, basé en Vendée, raccorde vos outils à des modèles open weight hébergés en Europe et vous aide à choisir le bon modèle pour chaque usage. Audit gratuit et sans engagement.
Questions fréquentes
Est-ce moins performant qu’un modèle propriétaire ?
Sur les tâches d’agent courantes, l’écart ne se voit plus vraiment. Ce qui compte pour un agent, c’est la fiabilité de l’appel d’outils et la taille de contexte, pas le score sur un classement généraliste. Sur du raisonnement de pointe, les modèles fermés gardent une avance, qui se réduit à chaque version.
Faut-il héberger le modèle soi-même pour être souverain ?
Pas nécessairement, et c’est rarement rentable pour une PME. Faire tourner un modèle de cette taille demande des cartes graphiques coûteuses et de l’exploitation. Passer par un hébergeur européen avec des engagements écrits offre un compromis raisonnable. L’auto-hébergement se justifie pour les données les plus sensibles, avec des modèles plus petits.
Suisse ou Union européenne, est-ce équivalent ?
Ce ne sont pas les mêmes cadres. La Suisse n’est pas dans l’Union européenne, mais elle bénéficie d’une décision d’adéquation, et sa loi sur la protection des données est proche du RGPD. Pour beaucoup d’organisations c’est acceptable, mais si votre cahier des charges impose un hébergement strictement dans l’Union, il faut le vérifier avant de s’engager.
Sources
- Catalogue des modèles open source, Infomaniak : identifiants, contextes, langues et appel de fonctions
- AI Services, Infomaniak : hébergement en Suisse, API compatible OpenAI et engagements sur les requêtes
- Custom providers and local runtimes, documentation OpenClaw : déclaration d’un fournisseur personnalisé et URL de base